人工智能芯片设计 从架构创新到智能计算的未来
引言
人工智能芯片是专门为加速机器学习算法(尤其是深度神经网络)而设计的计算硬件。与传统通用处理器(CPU)相比,AI芯片在能效比、并行度和吞吐量上实现了数量级的提升,成为支撑大模型训练与推理的核心基础设施。而人工智能芯片设计,则是在架构、电路、工艺和软件协同等多个层面进行系统化创新的工程实践。
一、AI芯片的核心分类与设计目标
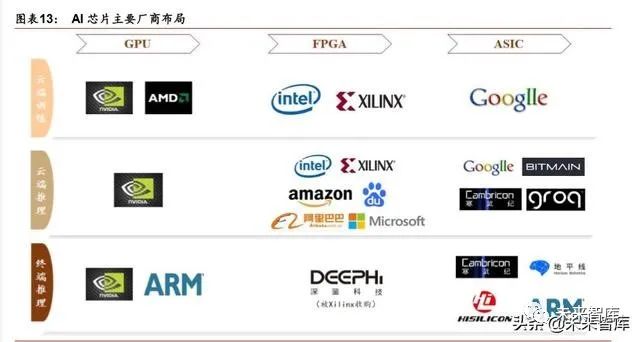
从设计定位来看,AI芯片主要分为训练芯片与推理芯片两大类。训练芯片追求极致的浮点算力和大内存带宽,需要支持高精度(FP32/BF16)计算與分布式并行;推理芯片则更强调低延迟、高能效和低成本,常采用INT8/INT4等量化精度。
设计目标可概括为三个维度:
- 算力密度:单位面积硅片提供的有效算力(TOPS/mm²);
- 能效比:每瓦功耗所能完成的运算次数(TOPS/W);
- 可编程性:芯片对不断演进的算法模型的适应能力,避免“设计即落后”。
二、主流架构设计路线
AI芯片设计在架构层面呈现多样化竞争格局,典型代表包括:
- GPU架构:凭借大规模SIMT并行和成熟的软件生态(如CUDA),主导训练市场。NVIDIA通过Tensor Core实现混合精度矩阵运算,Google TPU则以脉动阵列(Systolic Array)在推理与训练中取得高能效。
- 专用ASIC架构:针对特定算法固化硬件数据流,能效最高但灵活性受限,适用于边缘推理和特定云端负载。
- FPGA可重构架构:兼具硬件并行性与现场可编程性,适合小批量、低延迟场景,但单位算力成本偏高。
- 存算一体与近存计算:通过将计算单元嵌入存储阵列(如SRAM/ReRAM),缓解“存储墙”瓶颈,是近年设计创新的热点方向。
The design of AI chips increasingly follows a dataflow-driven approach: designers analyze the computation graph of neural networks (convolution, attention, matrix multiplication), and then map those operations onto processing element arrays with optimized on-chip memory hierarchy and interconnects. In other words, AI chip design is no longer just about adding MAC (multiply-accumulate) units; it is about co-designing the hardware dataflow with the algorithm’s memory access pattern.
具体而言,数据流设计需重点解决三个问题:权重与激活值的复用策略(如权重固定、输出固定、行固定数据流);片上缓存(SRAM)与高带宽内存(HBM)的层级划分;以及PE阵列与网络互连拓扑(NoC)的带宽匹配。只有让数据流动路径与算法访问模式高度契合,才能避免算力被数据搬运所吞噬。
三、设计流程与方法学
现代AI芯片设计遵循“算法—架构—电路—版图”的协同流程,并呈现软硬件协同设计(HW/SW Co-design)的显著趋势:
- 算法分析与建模:通过对目标网络的计算量、访存量和并行度进行剖析,确定计算精度、吞吐量和能效目标。
- 架构级设计:采用体系结构模拟器(如Gem5扩展)进行性能建模,权衡PE阵列规模、片上缓存容量與互连带宽。
- RTL实现与验证:使用Verilog/SystemVerilog完成寄存器传输级描述,借助UVM等方法学构建大规模验证平台,覆盖率驱动收敛。
- 物理设计:包括逻辑综合、布局布线、时序收敛与功耗分析,针对高带宽接口和密集计算阵列进行时钟树与电源网络优化。
- 软件栈设计:编译器(如图神经网络编译器TVM/XLA)、算子库与运行时调度,确保硬件能力被算法有效利用。
值得一提的是芯片设计中EDA工具与AI的融合:设计空间探索(DSE)正借助强化学习自动搜索PPA(性能、功耗、面积)最优的微架构参数,缩短设计周期。
四、关键挑战与前沿方向
AI芯片设计面临多重挑战:存储墙导致算力利用率受限于内存带宽,催生存算一体、近存计算等新型架构;能耗约束在边缘端尤为突出,推动事件驱动与稀疏计算设计;工艺与成本受先进制程限制,chiplet(芯粒)与小芯片异构集成成为延续性能提升的重要路径。
前沿方向还包括:面向大语言模型的稀疏化与混合精度架构设计;光电混合计算与神经形态芯片探索;以及RISC-V开放指令集架构在AI加速器中的定制化扩展。
##
人工智能芯片设计是算法需求牵引与硬件工程驱动的深度交集。优秀的AI芯片不是单一算力指标的堆砌,而是计算范式、存储层次、互连网络与软件生态的系统协同。随着模型规模与场景多样性的持续演进,AI芯片设计将更加依赖跨层协同创新,为智能计算提供可持续的算力底座。
如若转载,请注明出处:http://www.todayiots.com/product/28.html
更新时间:2026-10-21 06:14:19